【新機能】個人情報を含むインタビューも共有可能に。プライバシーマスク機能をリリースしました
こんにちは!toitta開発チームの米山(id:yone-yama)です。
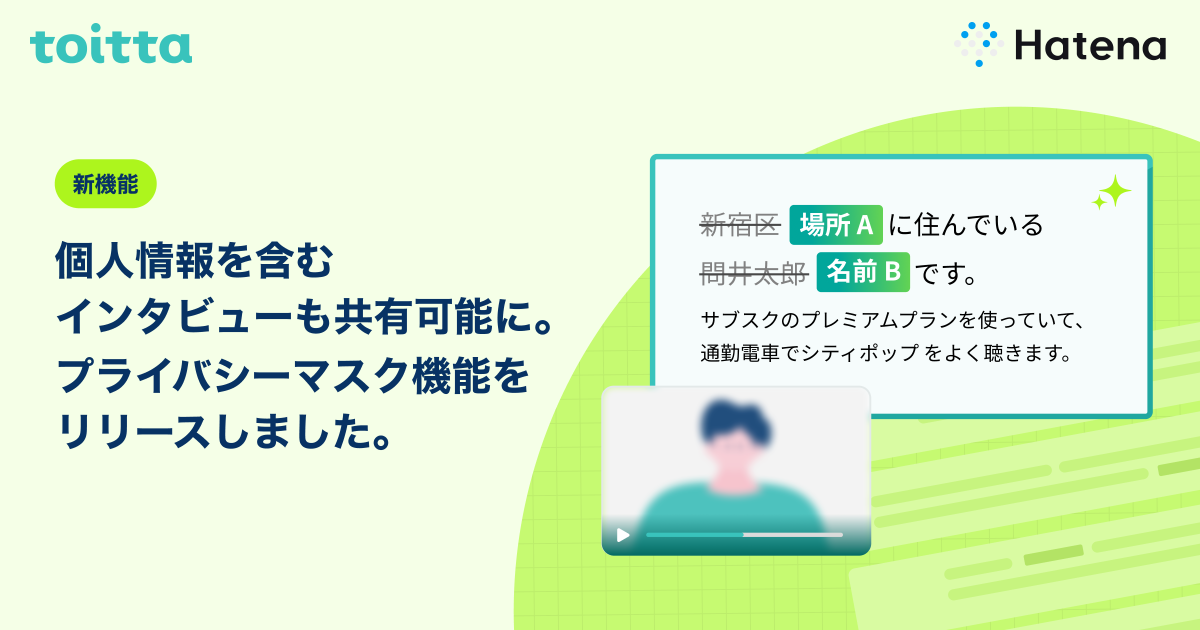
この度、toittaの新機能として「プライバシーマスク機能」の提供を開始しました。インタビューの映像・音声・書き起こしに含まれる、インタビュイー個人の特定につながる情報をAIが自動検出し、人間の確認・修正を経てマスクできるようになります。
toittaのプライバシーマスク機能とは
toittaは、インタビューの録画・録音データやテキストファイルから書き起こしと切片を自動生成し、インタビュー結果の分析を支援してきました。
ここで扱う「インタビューデータ」には、インタビュイーの氏名や勤務先など、個人の特定につながる情報が含まれることがあります。そのため、お客様からこんな声をいただくことがありました。
- 社内規程で個人情報を含むデータの保存期間が決まっていて、期限が来たら消さなければならない
- 個人情報が含まれるので、チーム外や社外に共有できない
こうした理由によって価値あるインタビューという資産を活用しきれないという課題は、過去本当に多くのお客様から寄せられてきました。お客様の中には、「すべての動画を目視で確認した上で、手元の動画編集ツールで加工してからアップロードする」という運用をされているケースもありました。
プライバシーマスク機能は、引き続きインタビューデータに含まれうる個人にまつわる情報の取り扱いに充分な配慮を行いつつ、その処理工程をtoittaの中で完結させるものとして開発しました。
プライバシーマスク機能の特徴
プライバシーマスク機能には4つの特徴があります。
- 本人の特定につながるさまざまな情報を自動検出します
- AIが提示するマスク候補は、人間が承認するまで確定しません
- 映像・音声・書き起こしすべてに反映されます
- マスク後でも「どんな人がなんと言ったか」が分かるデータです
全体の流れ
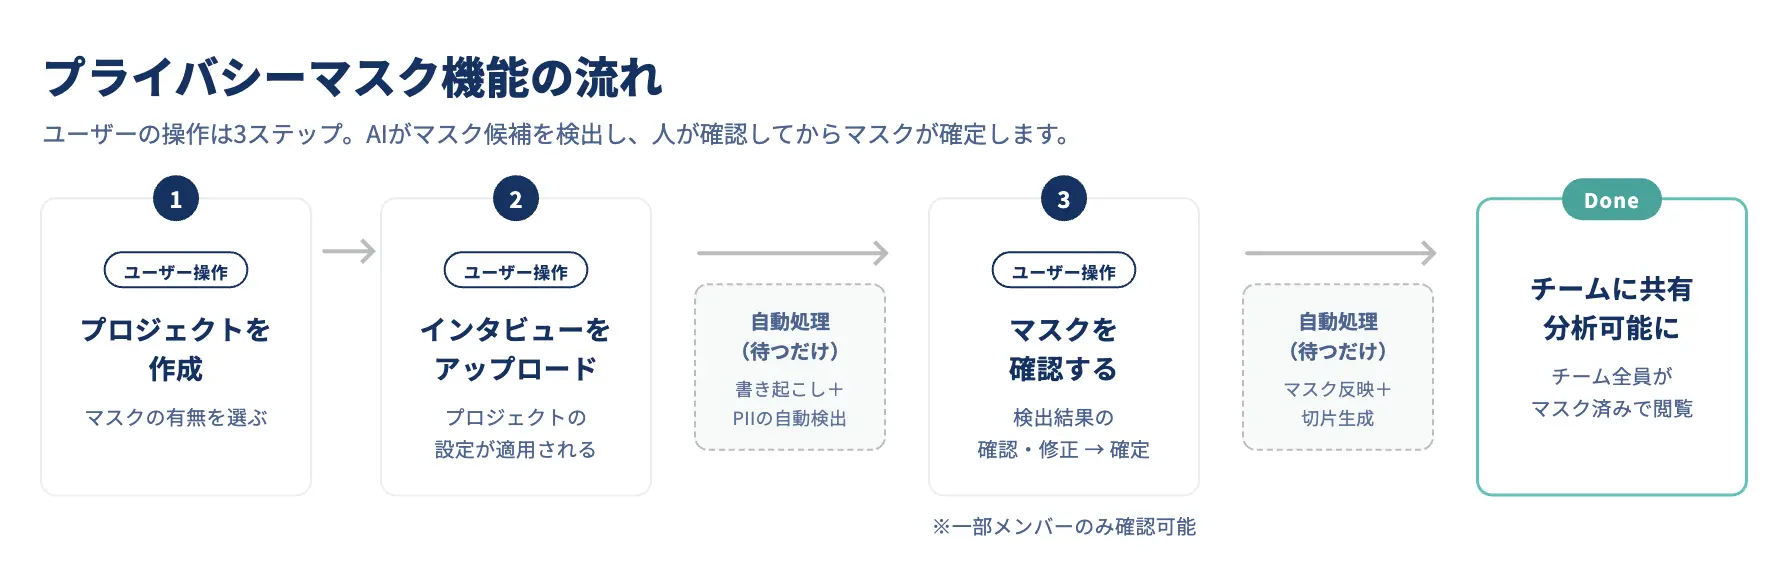
1. 本人の特定につながるさまざまな情報を自動検出します
自動検出の対象は、インタビュイー本人に関する次の情報です。
- 個人名
- 所属(会社名・学校名・団体名など。本人の特定につながる出身校・前職を含む)
- 居住地(市区町村・番地・建物名など、都道府県より細かいもの)
- 番号・連絡先(対象の人物の電話番号・メールアドレス・個人番号・郵便番号・生年月日など)
- 間接識別子(本人の所属企業の独自製品名、本人が営む店名など、組み合わせることで本人を特定しうる情報)
反対に、職種・業界名や広く使われているツール名といった一般的な表現は、過剰なマスクを避けるために自動検出の対象外にしています。「IT企業」「映像系の学部」のような、特定の組織を指さない言葉まで消えてしまうと、分析に使える情報が残らなくなるためです。
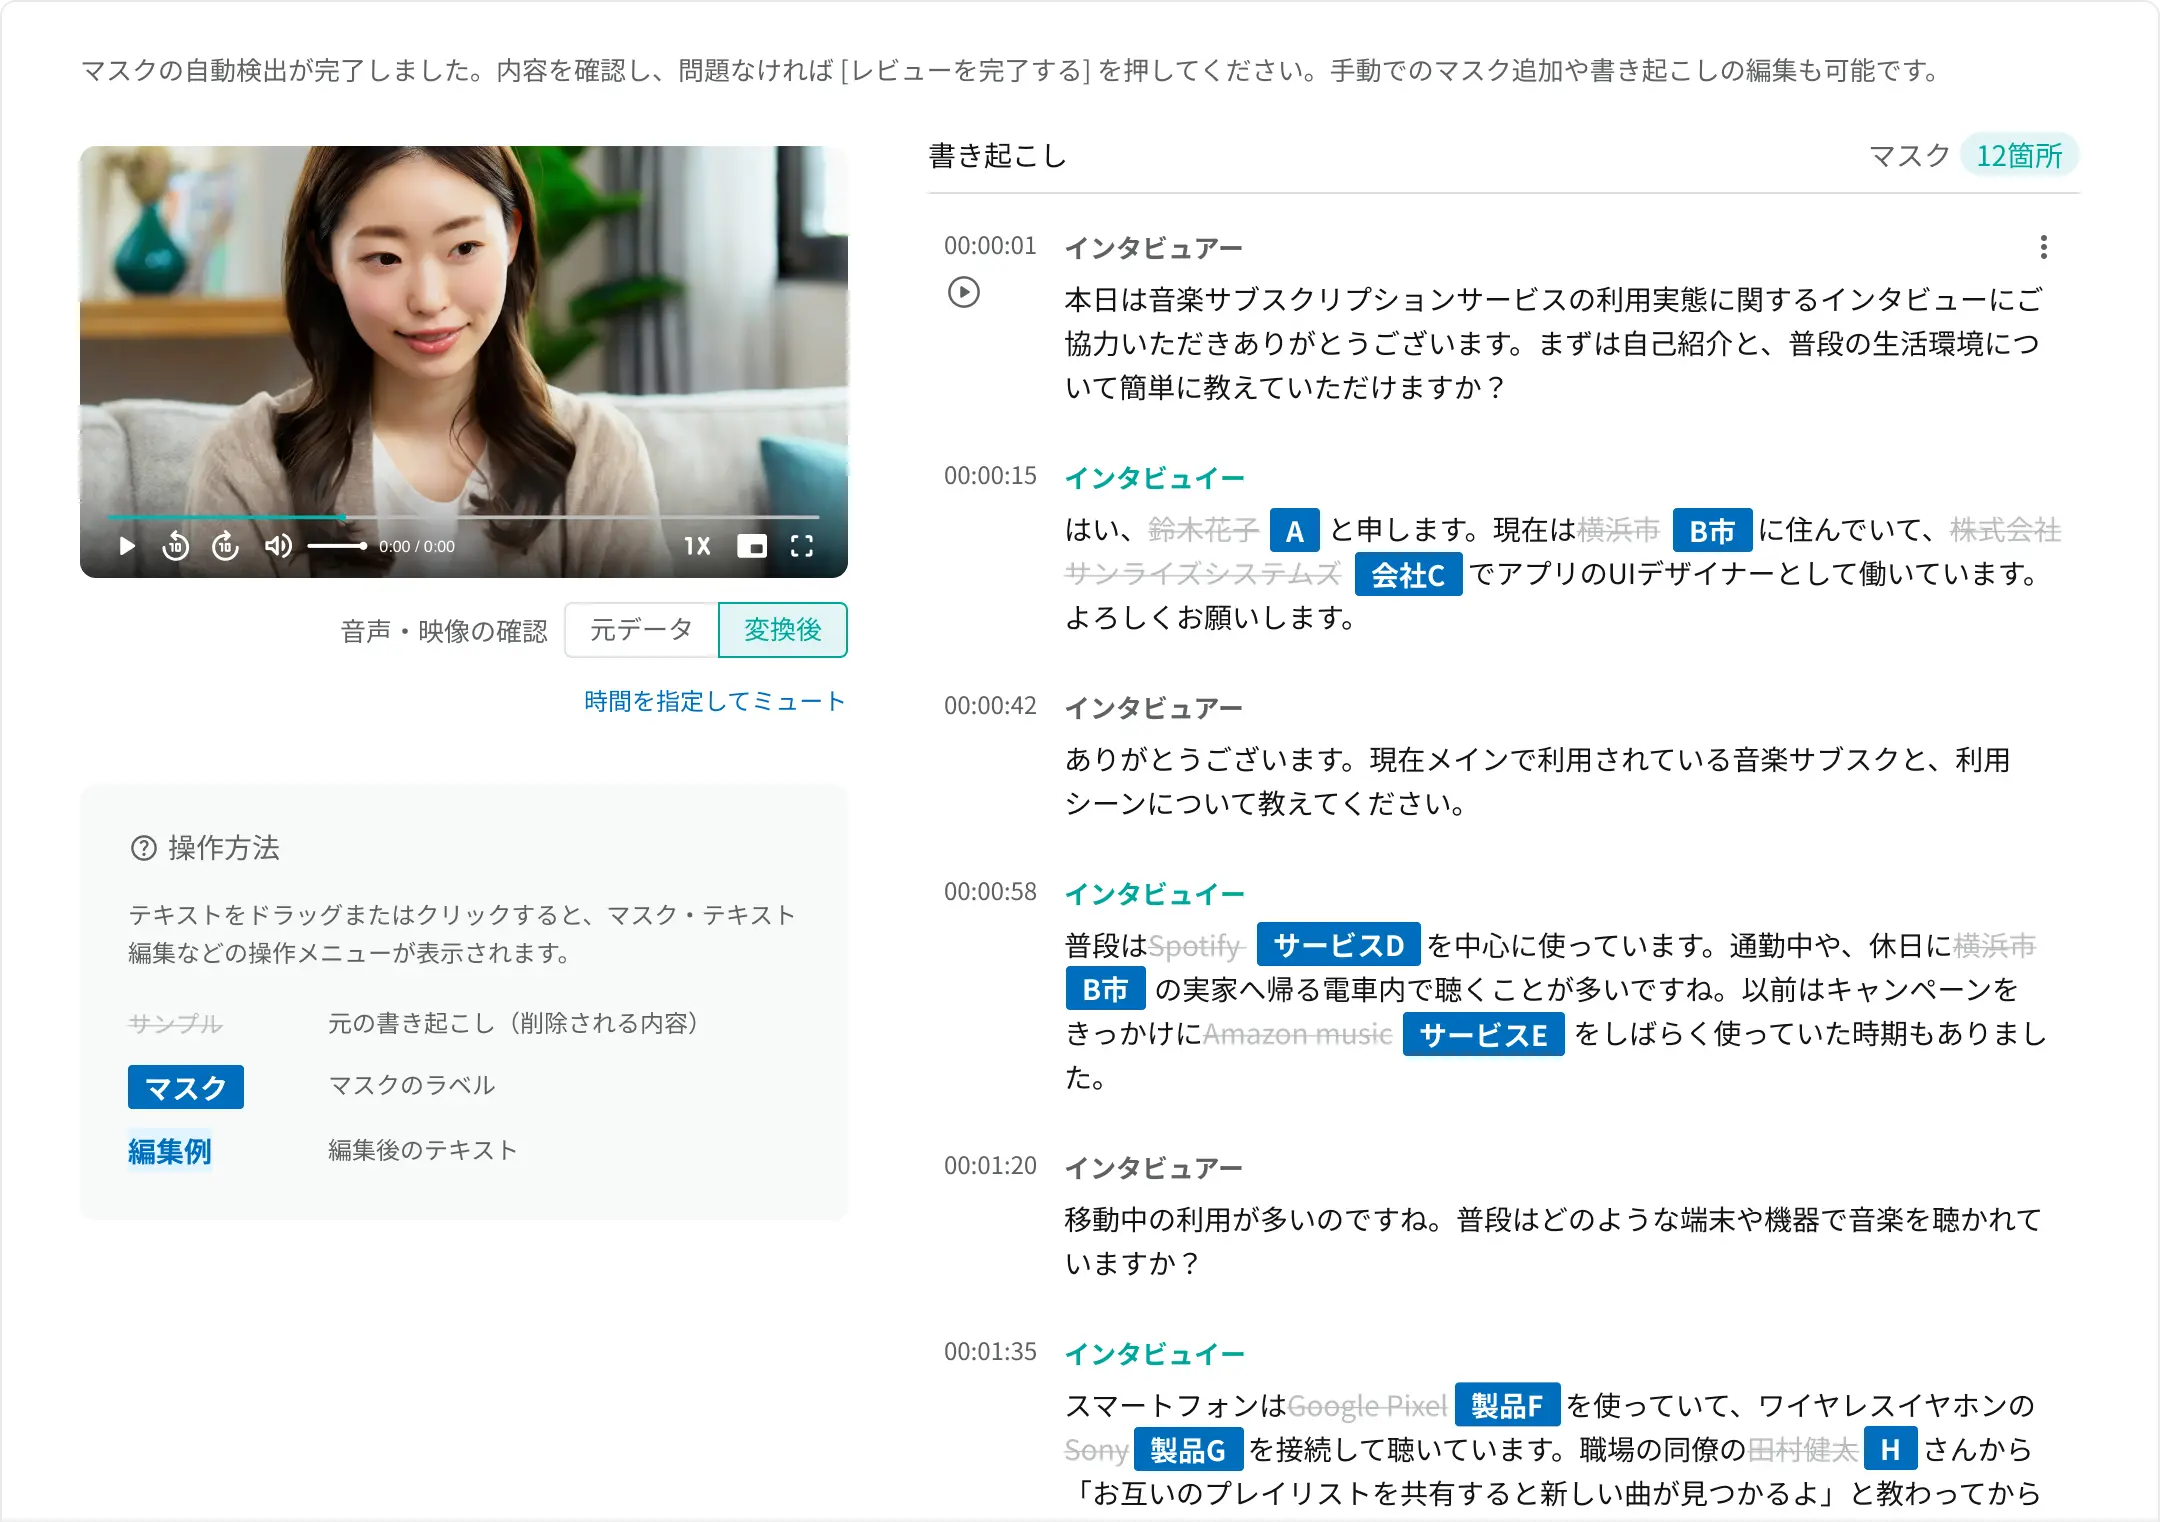
2. AIが提示するマスク候補は、人間が承認するまで確定しません
toittaのプライバシーマスク機能で大切にしたのは、自動検出はあくまで「候補の提示」であるという設計です。何をマスクすべきかは、企業や案件ごとのポリシーによって変わります。担当者はマスク前の映像と書き起こしを確認しながら候補の採否を判断し、検出漏れがあれば手動で追加して、マスク内容を確定します。最終的な判断は担当者の手元に残ります。
担当者がマスクを確定するまでそのインタビューは担当者自身と管理者のみが閲覧できます。切片・グルーピング・レポートも作られないので、分析や他メンバーの閲覧は、マスクが済んだデータに対してだけ行われます。
確認画面では、検出漏れの追加、過剰に検出された箇所の解除、表示名の変更、書き起こしの誤字修正ができます。言い直しなどで書き起こしに現れなかった発話も、再生しながら区間を指定して無音にできます。
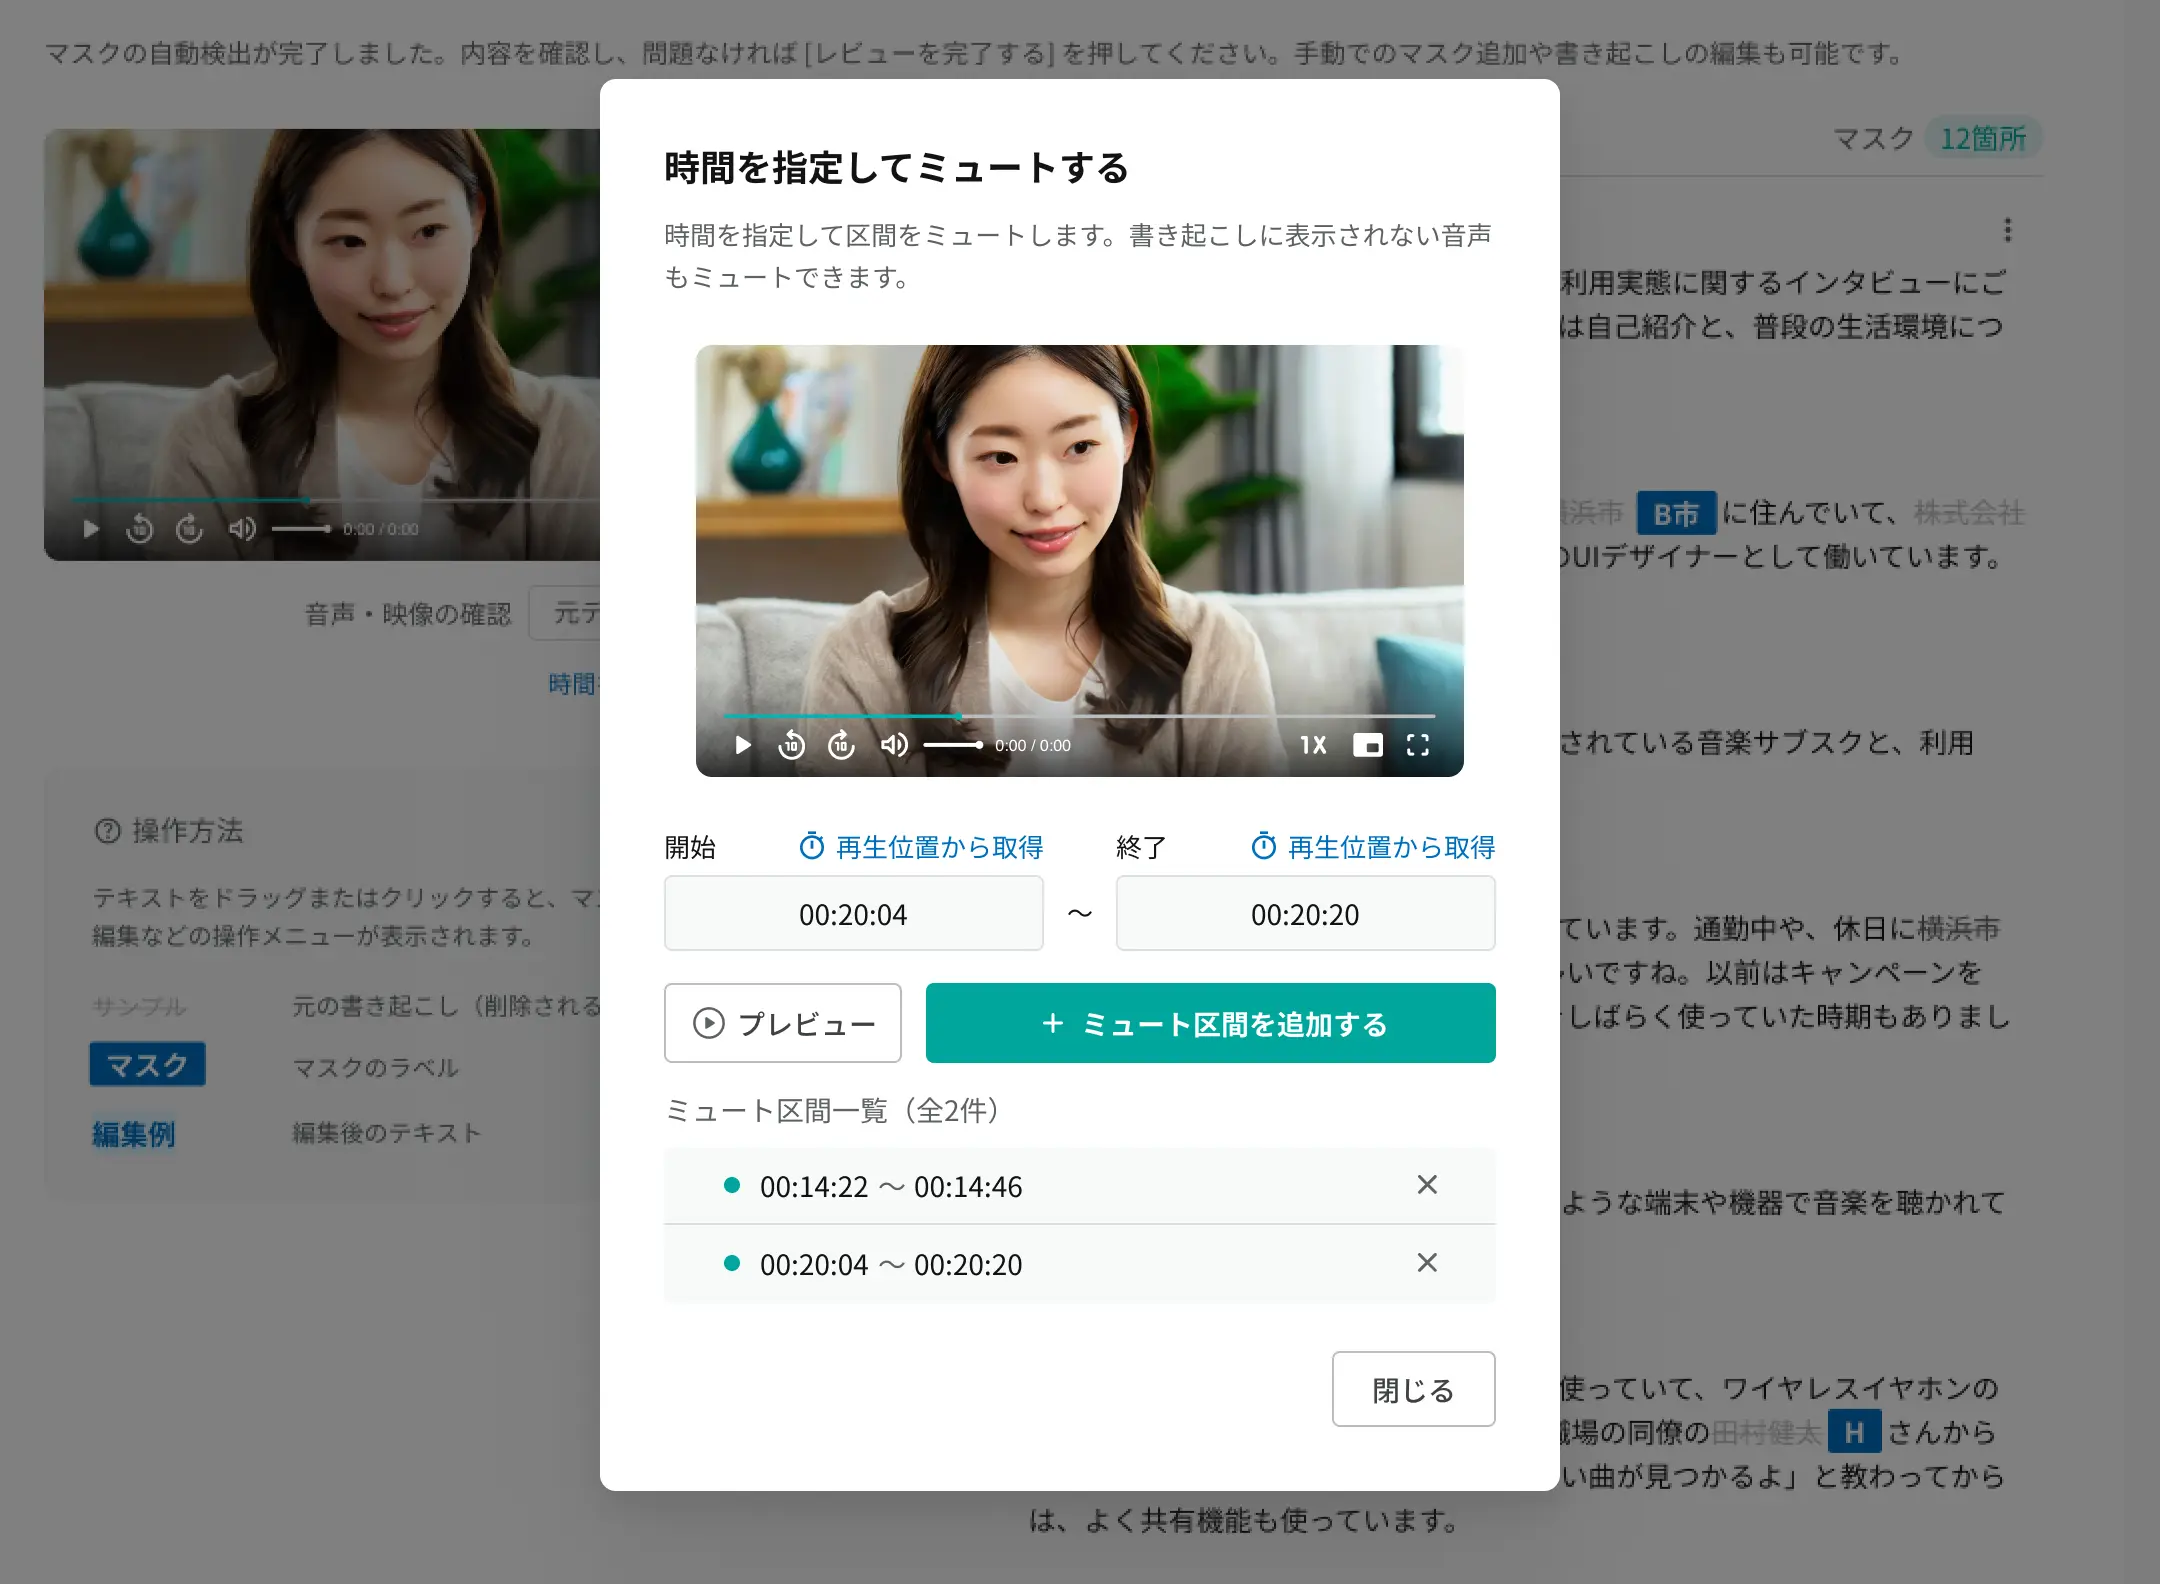
3. 映像・音声・書き起こしすべてに反映されます
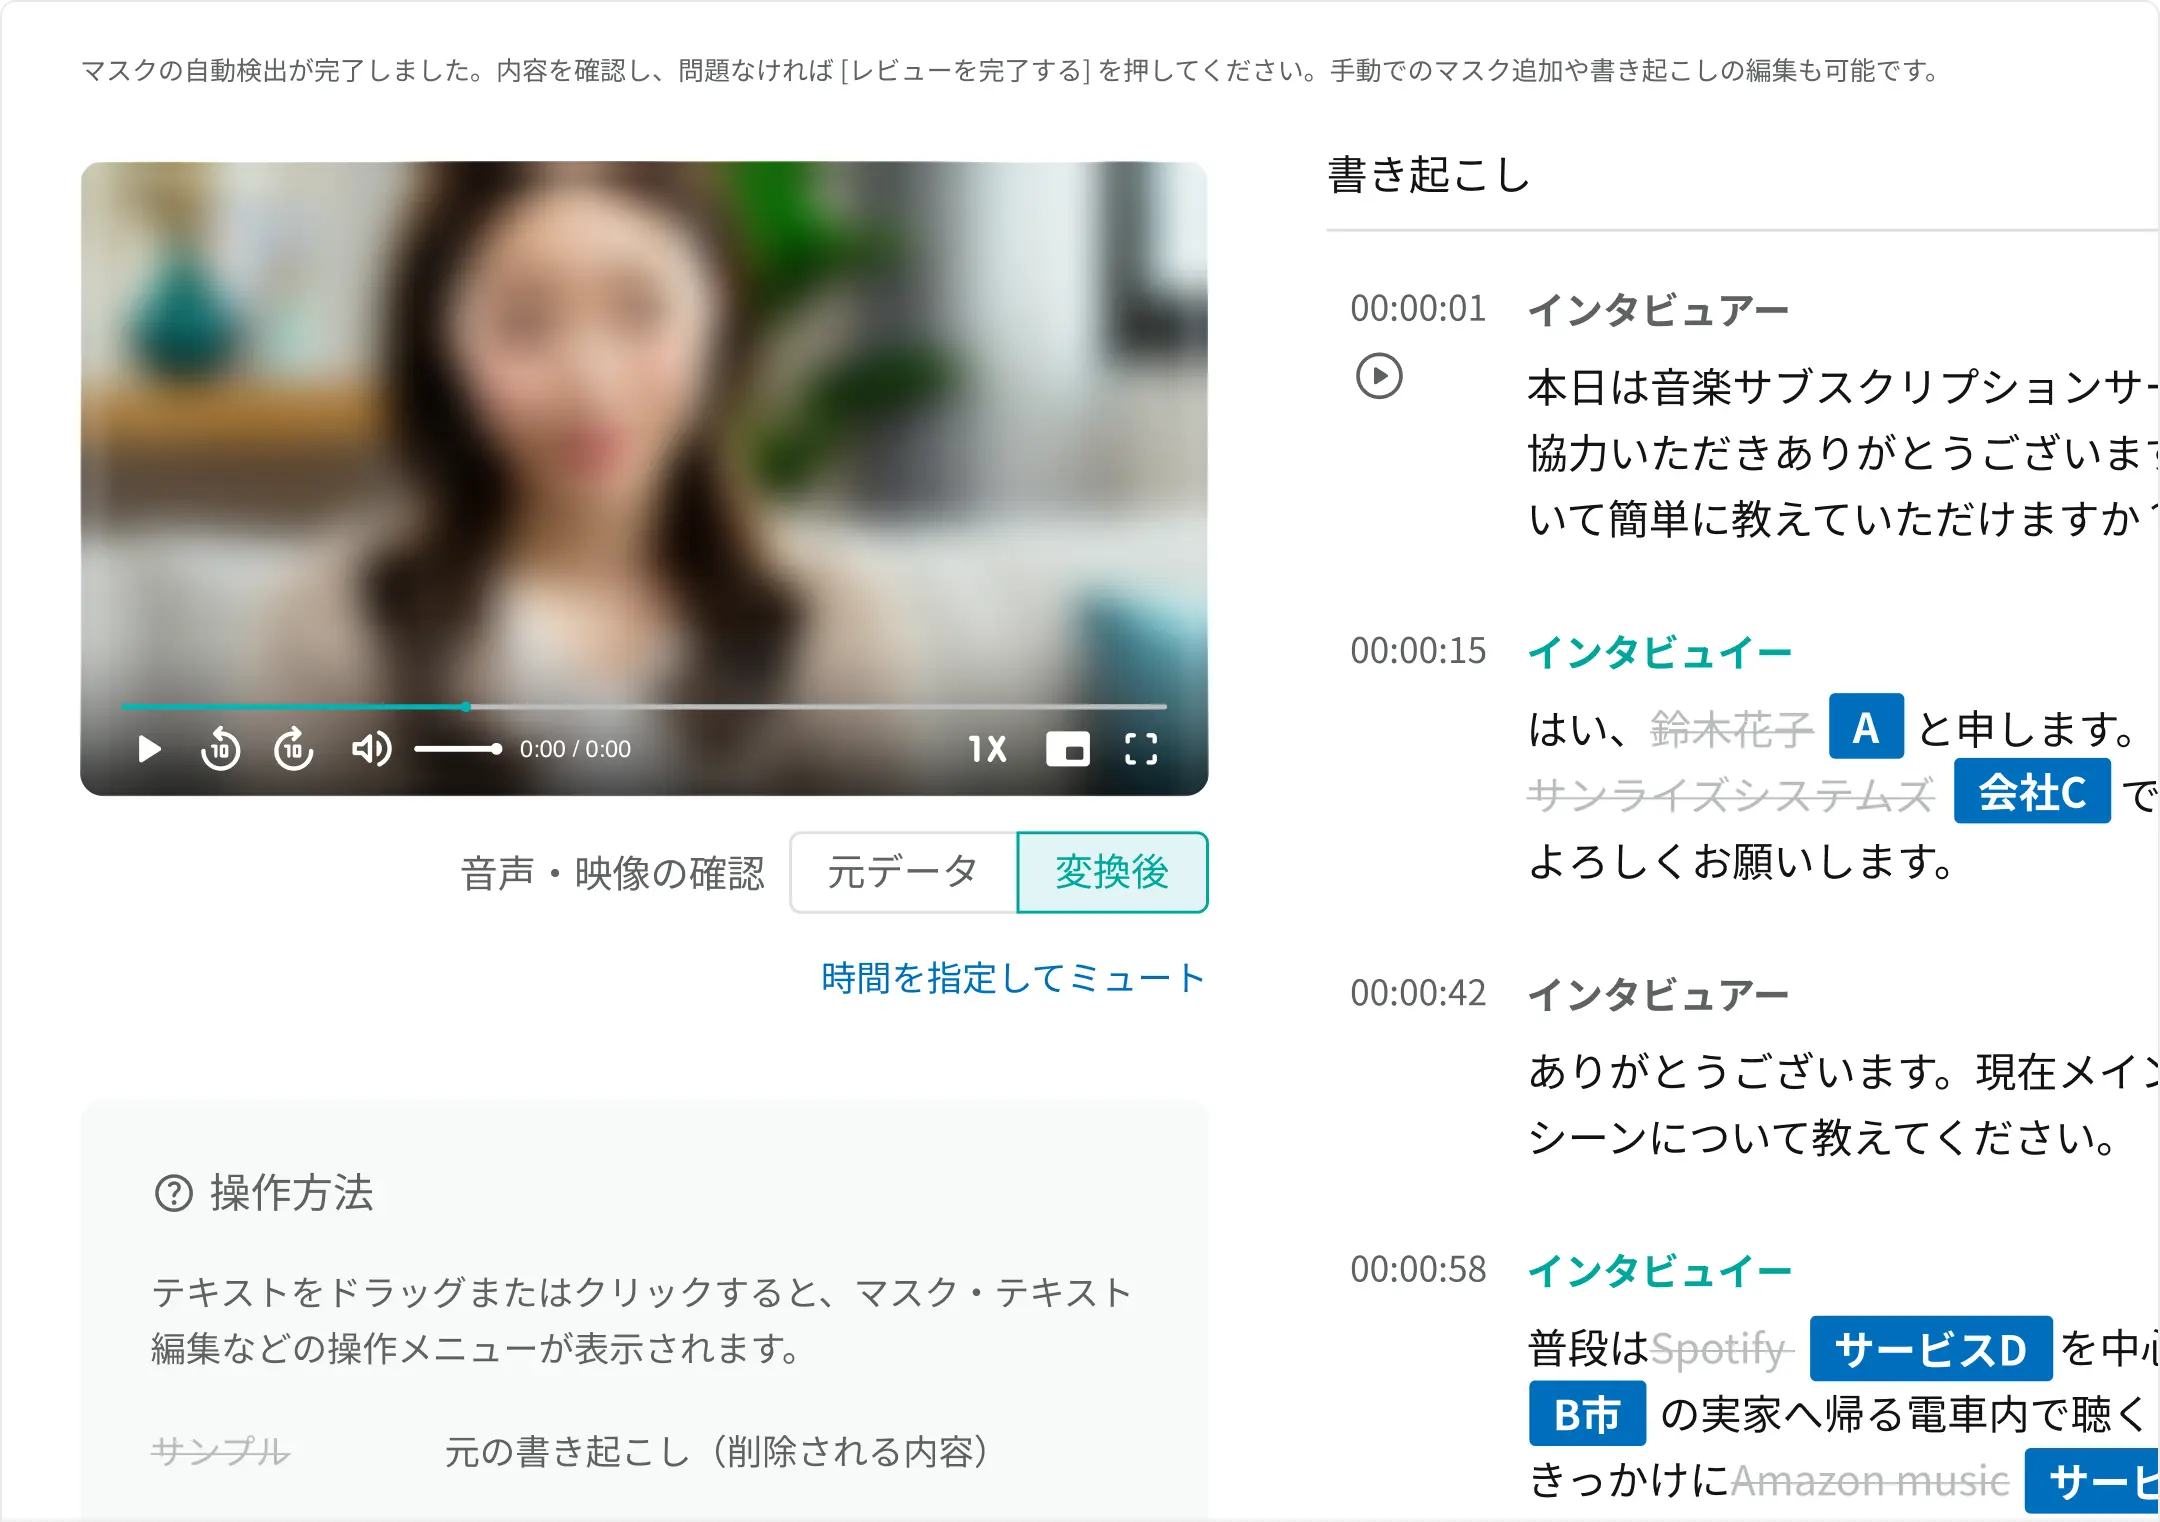
確定したマスクは、該当する箇所に反映されます。書き起こしでは表示名への置き換え、音声ではその区間の無音化です。
これとは別に、ファイル全体にかける処理をプロジェクトごとに選べます。
- 音声: そのまま残す/ボイスチェンジをかける/音声を消す
- 映像: そのまま残す/画面全体にぼかしをかける/映像を消す
4. マスク後でも「どんな人がなんと言ったか」が分かるデータです
同じ人物・同じ場所には、一貫した表示名(仮名)が割り当てられます。例えば人物なら「Aさん」「Bさん」のように区別がつき、一貫して同一人物であることはマスク後でも分かります。そのため、誰が何を言ったかの関係を保つことが重要である発話の分析や文脈の理解を阻害しません。なお、表示名は「A社の担当者」のように、読みやすい形に変更することもできます。
マスクされるのは必要な箇所に限られるので、発話のトーンや前後の文脈も残ります。切片やレポートは、マスクを反映したあとの書き起こしから作られます。
マスク前後のデータの扱いについて
マスク前データ
マスク前のデータは処理の過程でクラウドに保存され、検出のために外部のAIモデルに送信されます。本機能は社内での取り扱いを安全にするためのもので、個人情報の取り扱いを外部に委託しない状態を作る機能ではない点は、あらかじめご理解ください。
確認中データ
マスク箇所を自動検出後の確認中インタビューには、まだマスクされていない映像・音声・書き起こしが含まれるため、確認できる方を通常の閲覧範囲より狭く限定しています。
マスク前のデータを確認・編集できるのは、インタビューをアップロードしたご本人と、アップロード先チームの管理者(admin)権限を持つ方のみです。それ以外の方には、そのインタビューが「マスク確認中」であることだけが表示されます。
確定後のデータ
確定後は、マスク前のデータを誰も閲覧できなくなります。処理の完了後、速やかに削除されます。編集権限をお持ちの方であっても、マスク前の内容に戻ることはできません。
ご利用にあたって
本機能の目的と自動検出の精度
本機能で目指したのは、プライバシー情報を適切に取り扱うために人間が打ち込むコストを最小限にすることです。
前述の通り、この機能はなるべく分析上有効な文脈を残す意図から、マスクが過剰にも過小にもならないよう、複数の指標を見てバランスを調整しています。参考までに、リリース前に行った2026年10月の社内試験では、人間がマスクすべきと判断した箇所のうちAIも検出できた割合(見逃しの少なさ)は97%、AIが検出した箇所のうち人間もマスクすべきと判断した割合(過剰検出の少なさ)は98%で、良好な結果が得られています。
今後も改善は進めますが、イレギュラーなケース(書き起こしでの固有名詞の誤字や、言い直しで書き起こしに現れなかった発話など)はAIが見逃すことがあります。そこで本機能では、事前に人間による確認・承認を経たもののみを確定させる仕様にしています。
ご利用方法
プライバシーマスク機能のご利用には、お申し込みが必要です。利用方法やプランの詳細についてはお問い合わせください。
最後に
インタビューデータは、本来なら組織の中で広く使われるべき資産です。一方でインタビューデータは、時によって調査対象者さま個人の情報、尊重・秘匿されるべき重要な情報を含むセンシティブな資産であることも忘れてはなりません。データガバナンスと活用機会拡大の両立を目指す機能として、toittaのプライバシーマスク機能をぜひご活用ください!